A NVIDIA troca a segurança de modelos de IA com CVMs e GPUs confidenciais. A nova tecnologia usa criptografia de memória para proteger dados sensíveis. A eficiência energética é prioridade em fábricas de IA.
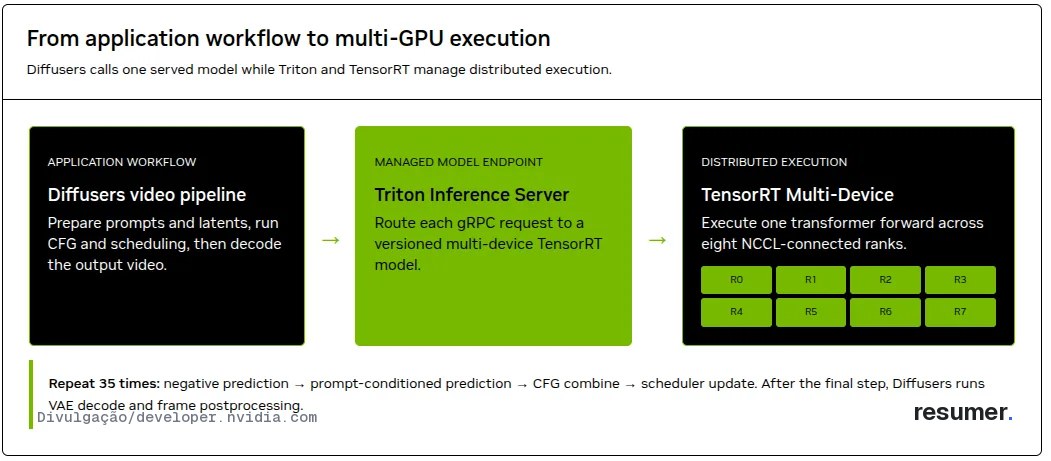
A empresa apresentou uma nova capacidade chamada TensorRT multi-device inference, que permite executar uma rede TensorRT em múltiplos GPUs. A funcionalidade é suportada a partir da versão 11.0 do TensorRT. A plataforma Vera Rubin foi projetada para otimizar o uso de energia em inferências de alta interatividade.
A NVIDIA DSX MaxLPS aumentou a performance por watt em 23% para Lambda e pode permitir até 40% mais capacidade de GPU em ambientes adequados. A próxima geração de GPUs NVIDIA, provavelmente chamada RTX 60, teria sido adiada para 2028. A empresa está focando em soluções para processamento seguro de modelos de IA em ambientes privados, com ênfase em eficiência energética e infraestrutura de IA.
A tecnologia NVIDIA Confidential Computing combina CVMs com criptografia de memória e GPUs confidenciais para proteger dados sensíveis. A colaboração com empresas como Amazon, d-Matrix e Lambda destaca a eficiência energética das soluções. A NVIDIA também trabalha com parcerias para otimizar o uso de energia em fábricas de IA, como a DSX MaxLPS e a plataforma Vera Rubin.
Ficha técnica
| Item | Especificação |
|---|---|
| Tecnologia | NVIDIA Confidential Computing; outra fonte: TensorRT multi-device inference |
| Aumento de capacidade de GPU | até 40% |
TensorRT 11.0 divide trabalho entre GPUs e melhora eficiência
A NVIDIA expande o TensorRT com multi-device inference, que divide o trabalho entre GPUs. Isso permite rodar modelos de IA em mais hardware, sem sobrecarregar um único chip. A eficiência energética ganha força com o aumento de 23% no desempenho por watt.
Fábricas de IA priorizam essa métrica, já que reduz custos operacionais. Isso significa que o sistema pode lidar com mais cargas de trabalho sem perder velocidade. A nova tecnologia ajuda a otimizar o uso de recursos, tornando a infraestrutura mais flexível.
A mudança impacta diretamente quem precisa processar grandes volumes de dados em tempo real. Isso é especialmente útil para aplicações que demandam alta disponibilidade e desempenho contínuo. A tecnologia também integra melhorias na gestão de recursos, garantindo que a infraestrutura responda de forma ágil a variações na carga de trabalho.
NVIDIA amplia segurança com multi-GPU e criptografia
A NVIDIA avança em segurança e eficiência para IA. A empresa já trabalhava em soluções para proteger dados em ambientes privados, com parcerias como a DSX MaxLPS e a Vera Rubin. A nova tecnologia expande essa linha, unindo criptografia e multi-GPU.
Antes, a empresa focava em otimizar energia em fábricas de IA, mas agora também prioriza proteção de contexto. A mudança reflete a demanda por IA segura e eficiente. A eficiência por watt é prioridade, assim como a capacidade de processar modelos grandes.
A nova capacidade do TensorRT 11.0 permite dividir trabalho entre GPUs, mas agora também protege dados sensíveis. Agora, a empresa amplia essa estratégia com tecnologias que protegem dados sensíveis e contexto proprietário. A nova capacidade do TensorRT 11.0 não só divide tarefas entre GPUs, mas também integra criptografia de memória para segurança. Isso mostra como a empresa evoluiu para atender demandas de ambientes privados e proteção de informações.
NVIDIA prioriza segurança e eficiência em IA
A NVIDIA amplia a segurança com CVMs e GPUs confidenciais, enquanto a eficiência energética se torna prioridade em fábricas de IA. A nova tecnologia Confidential Computing protege dados sensíveis durante o processamento de modelos de IA, usando criptografia de memória em máquinas virtuais confidenciais. A TensorRT multi-device inference divide o trabalho entre GPUs, aumentando a capacidade de processamento sem comprometer a latência.
A NVIDIA teria adiado o lançamento da RTX 60 mais de uma vez, inicialmente previsto para 2027.
NVIDIA não confirma preço e disponibilidade no Brasil
- Preço e data no Brasil não informados.
Fontes
- Enabling private high performance production ai inference with nvidia confidential computingdeveloper.nvidia.com
- Simplifying model serving across multiple gpus with nvidia tensorrt multi device integration in nvidia dynamo tritondeveloper.nvidia.com
- How nvidia groq 3 lpx deterministic execution drives power efficient high interactivity inference on nvidia vera rubindeveloper.nvidia.com
- Ai infra summit vera rubin dsx energy efficiencies tokens per watt ai factoriesblogs.nvidia.com
- Placas nvidia rtx 60 chegam apenas em 2028 diz insideradrenaline.com.br