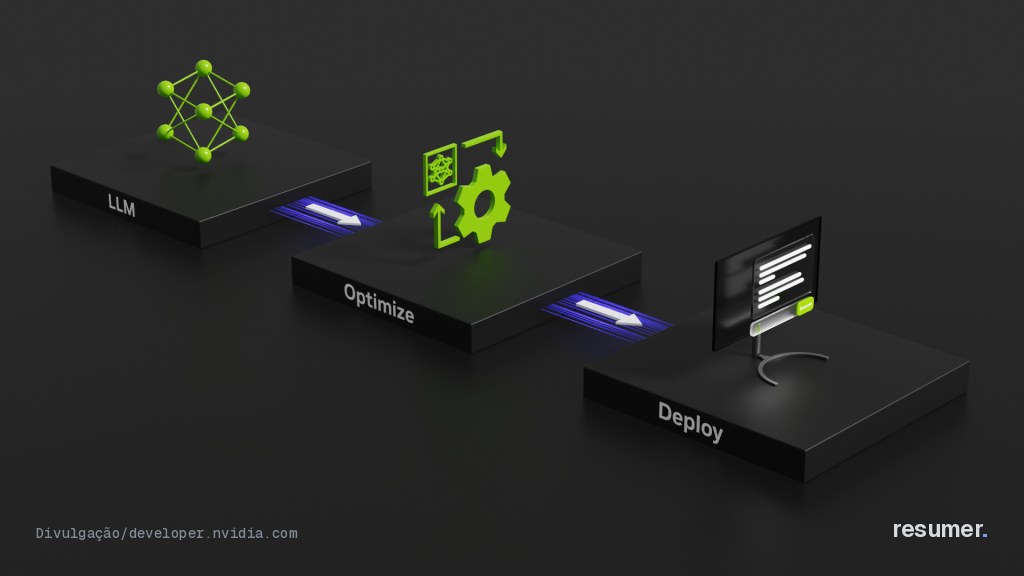
A NVIDIA lança o TensorRT Edge-LLM, software que acelera agentes de IA em 6,4 vezes no Jetson AGX Thor. A ferramenta integra o MLPerf Edge Agentic Benchmark e mira o novo perfil de agentes de IA, que migram da nuvem para veículos e robôs. Esses agentes encadeiam passos como seleção de ferramentas e raciocínio contínuo, diferente de chatbots que só respondem perguntas isoladas.
A NVIDIA anuncia o TensorRT Edge-LLM em post no blog oficial para desenvolvedores, publicado nesta semana. A empresa explica que o novo fluxo de trabalho dos agentes impõe uma exigência distinta dos chatbots tradicionais: gerar tokens (as unidades de texto processadas pelo modelo) com velocidade suficiente para sustentar decisões em tempo real. Cada etapa do raciocínio depende da anterior.
A companhia soma esse lançamento a outro resultado, obtido em benchmark separado: o MLPerf Training v6.0, voltado a treinamento de modelos, não à inferência em borda que o Edge-LLM mira. Nele, o sistema GB300 NVL72 lidera as marcas do setor ao conectar 72 GPUs Blackwell Ultra e 36 CPUs Grace por NVLink, a interconexão de alta velocidade da própria NVIDIA entre processadores.
Com essa arquitetura, a empresa treinou o modelo DeepSeek-V3, que soma 671 bilhões de parâmetros e usa a técnica MoE (mistura de especialistas, que ativa só partes da rede por tarefa), em 2,02 minutos, com 8.192 GPUs trabalhando em paralelo. Os dois anúncios reforçam a mesma estratégia: a NVIDIA amplia o alcance do TensorRT-LLM, seu pacote de software para inferência, tanto para data centers quanto para dispositivos fora da nuvem. A avaliação de resultados pelo próprio agente — um dos passos que o distingue de um chatbot comum — também exige esse ritmo de processamento.
O ganho de velocidade do TensorRT Edge-LLM aparece no título do post oficial da NVIDIA, mas o texto não detalha a metodologia por trás do número. Para quem desenvolve agentes de IA embarcados, isso significa mais passos de raciocínio executados por segundo no mesmo hardware, sem trocar a placa do robô ou do veículo. A NVIDIA também trouxe, no mesmo material, dados de um benchmark separado: o MLPerf Training v6.0, que mede treinamento de modelos gigantes na nuvem, não inferência de borda.
Ali, o sistema GB300 NVL72 liderou os resultados: o treinamento levou pouco mais de dois minutos, com 8.192 GPUs simultâneas. Os dois benchmarks resolvem problemas diferentes — o Edge Agentic mede a velocidade de resposta do agente no dispositivo físico, enquanto o Training v6.0 mede a velocidade de treino antes da distribuição dos modelos. A NVIDIA cita o segundo caso para mostrar que domina as duas pontas da cadeia, da nuvem até o hardware dentro do robô.
Ficha técnica
| Item | Especificação |
|---|---|
| Ganho de desempenho | 6,4x mais rápido no Jetson AGX Thor |
| Modelo treinado (contexto) | DeepSeek-V3, 671B parâmetros (MoE) |
TensorRT-LLM ganha capítulo dedicado à borda
O TensorRT Edge-LLM nasce como extensão do TensorRT-LLM, pilha de inferência que a NVIDIA já mantém para servidores e nuvem. A empresa estende essa base para o Jetson AGX Thor, hardware voltado à robótica e veículos autônomos. O movimento acompanha a migração de agentes de IA de múltiplas etapas do data center para o dispositivo — um padrão recente da companhia, que busca dominar os benchmarks do consórcio MLCommons.
Em treinamento, a NVIDIA varreu o MLPerf Training v6.0 e liderou cada teste do ciclo com hardware de geração mais recente. A própria empresa chama o resultado de varredura completa. Agora a disputa migra para a inferência de agentes na borda, terreno também ocupado por pilhas concorrentes como vLLM e SGLang, citadas pela comunidade de desenvolvedores ao lado do TensorRT-LLM. A NVIDIA não cita, no post, resultados de rivais nesse benchmark específico de agentes — só reforça a evolução da própria pilha.
Agentes redefinem a régua de desempenho
O TensorRT Edge-LLM desloca o critério de desempenho na borda: não basta responder rápido, é preciso sustentar uma sequência de decisões sem perder velocidade. Um agente escolhe uma ferramenta, avalia o resultado e decide o próximo passo. Essa cadeia repete chamadas ao modelo a cada tarefa e expõe qualquer gargalo com mais força do que uma pergunta única de chatbot.
A NVIDIA conecta essa mudança ao MLPerf Edge Agentic Benchmark, que passa a comparar hardware e software de borda pelo fluxo completo do agente, e não por uma resposta isolada. Fabricantes de robôs, veículos autônomos e outros dispositivos ganham um parâmetro comum para medir se seus sistemas suportam esse tipo de carga antes de tirar o modelo do data center. A comparação entre diferentes fornecedores deve aparecer nas próximas rodadas do próprio MLPerf.
Sem data de lançamento nem preço confirmados
- Data de lançamento ou disponibilidade do TensorRT Edge-LLM não confirmada nas fontes
- Ganho de 6,4x aparece apenas no título/URL, sem confirmação no corpo do texto da fonte
Fontes
- Tensorrt edge llm completes the mlperf edge agentic benchmark 6 4x faster on jetson agx thordeveloper.nvidia.com
- Nvidia blackwell tops mlperf training 6 0 with industry leading scale and performancedeveloper.nvidia.com
- Llm inference 4 7 the software stack behind high performance llm inferencemedium.com
- ithome.com
- Samsung renova linha de tvs premium com micro rgb oled e neo qledtecnoblog.net