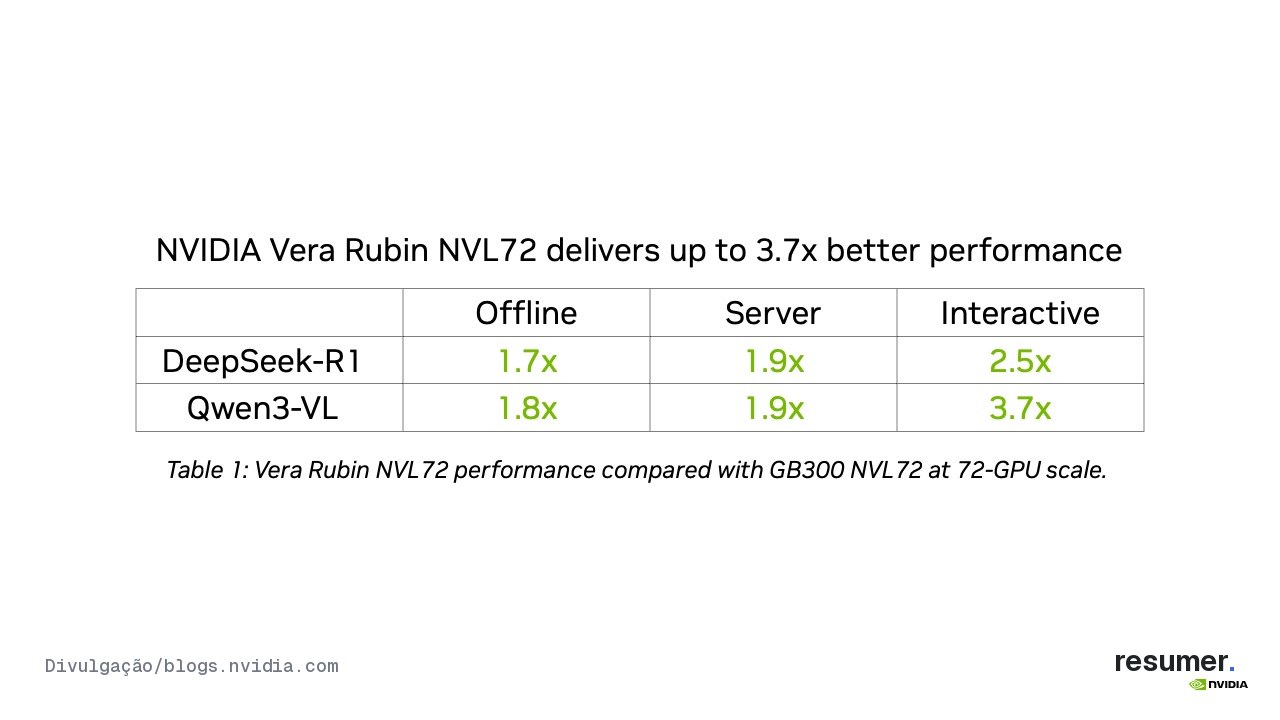
A NVIDIA estreia o Vera Rubin NVL72, sucessor do GB300 NVL72, no MLPerf Inference v6.1. Os resultados, da categoria Preview, saem em 16 de setembro de 2026. No benchmark Qwen3-VL, o novo sistema entrega até 3,7 vezes mais throughput, o volume de tokens processados por segundo, que o GB300 NVL72.
A NVIDIA também mede o desempenho no DeepSeek-R1, modelo de raciocínio que passa por várias etapas de inferência até chegar a uma resposta. O Vera Rubin NVL72 roda sobre a biblioteca TensorRT-LLM, que otimiza a execução de modelos de linguagem em GPUs da própria NVIDIA. Nesse teste, processa até 2,5 vezes mais tokens por segundo que o GB300 NVL72.
A empresa publica os resultados no site do MLCommons, entidade que organiza o benchmark, sob as submissões 6.1-0106 e 6.1-0074. Uma das submissões testa o escalonamento: 288 GPUs, reunidas em quatro racks GB300 NVL72, atingem 99% de eficiência no cenário offline do DeepSeek-R1. O número mostra que somar mais GPUs não reduz o desempenho proporcional de cada uma, gargalo comum em clusters grandes.
A NVIDIA divulga ainda dados fora do MLPerf oficial, ligados a cargas de trabalho agentic — tarefas em que um agente de IA executa várias etapas sem intervenção humana e consome muito mais tokens que um chat simples. No benchmark SemiAnalysis AgentX, a empresa reporta até 30 vezes mais desempenho por megawatt frente ao GB300 NVL72. Em blog atualizado em 15 de setembro, ela cita também custo até 45 vezes menor por milhão de tokens processados nesse tipo de carga.
Ficha técnica
| Item | Especificação |
|---|---|
| Throughput Qwen3-VL (vs. GB300 NVL72) | até 3,7x maior |
| Throughput DeepSeek-R1 com TensorRT-LLM (vs. GB300 NVL72) | até 2,5x maior |
| Performance por megawatt no benchmark AgentX (vs. GB300… | até 30x maior (dado NVIDIA) |
| Custo por milhão de tokens agentic (vs. GB300 NVL72) | até 45x menor (dado NVIDIA) |
| Data das submissões Closed division | 16/09/2026 (submissões 6.1-0106 e 6.1-0074) |
Preço e disponibilidade
| Versão | Preço | Mercado | Disponibilidade |
|---|---|---|---|
| NVIDIA Vera Rubin NVL72 | US$ 1 | — | — |
"Não informado": a fonte não deu o valor, e a redação não estima preço para o Brasil.
Racks somam GPUs sem perder eficiência
O sistema também acelera o DeepSeek-R1, modelo de raciocínio que passa por várias etapas até chegar a uma resposta, com vazão de processamento até 2,5 vezes maior que o GB300 NVL72 ao rodar sobre o TensorRT-LLM, biblioteca da NVIDIA que otimiza a execução de modelos grandes em GPUs. Na prática, isso significa menos tempo de espera para cada cadeia de raciocínio e mais respostas entregues no mesmo intervalo. A NVIDIA também mede como o Vera Rubin NVL72 se comporta quando várias unidades trabalham em conjunto.
Isso quer dizer que somar racks praticamente não derruba o desempenho: dobrar o número de GPUs dobra, quase por inteiro, a capacidade de processamento do conjunto. Para quem opera data centers com múltiplos racks, o número mostra que ampliar a infraestrutura escala de forma previsível, sem o gargalo comum em arquiteturas que perdem eficiência conforme crescem.
Blackwell cede lugar à arquitetura Rubin
O Vera Rubin NVL72 sucede o GB300 NVL72, sistema baseado na arquitetura Blackwell que serve de régua para todos os ganhos anunciados pela NVIDIA. A nova plataforma reúne seis peças desenhadas juntas: a GPU Rubin, a CPU Vera, o switch NVLink 6, a rede ConnectX-9, o processador de dados BlueField-4 e o switch Spectrum-6. A disputa não é só interna.
A AMD leva ao MLPerf v6.1 um cluster com 512 GPUs Instinct MI355X, o maior já submetido ao benchmark, além da linha MI350P. A Intel entra com processadores Xeon 6 e a GPU de estação de trabalho Arc Pro B70.
O pano de fundo dessa corrida é a ascensão das cargas de trabalho agentic, que consomem muito mais tokens que um chat comum. Isso faz da eficiência energética e do custo por token as métricas que definem quem lidera essa nova geração de hardware.
A eficiência energética também vira ponto de disputa entre as empresas. A própria SemiAnalysis, dona do teste, mede um salto bem menor, de até 7 vezes, em software que ainda não chegou ao mercado — número que também destoa do 3x que Jensen Huang citou na GTC 2026.
A empresa também projeta custo até 45 vezes menor por milhão de tokens processados em cargas de trabalho agentic, tarefas que exigem decisões encadeadas de um modelo de IA. Enquanto isso, a AMD amplia a escala: o cluster Instinct MI355X, com 512 GPUs, lidera o DeepSeek R1 e o GPT-OSS 120B nessa rodada do MLPerf.
A Nebius também enviou resultados preview do Vera Rubin NVL72 na mesma divisão. As submissões da NVIDIA aparecem no site do MLCommons sob os códigos 6.1-0106 e 6.1-0074, ainda à espera de validação oficial.
Preço e data de venda seguem sem confirmação
- Data de disponibilidade comercial (venda ao público) não confirmada.
Fontes
- Vera rubin nvl72 mlperf inferenceblogs.nvidia.com
- Nvidia vera rubin nvl72 posts first mlperf inference preview resultsunite.ai
- Vera rubin nvl72 efficiency ai agentsblogs.nvidia.com
- Vera rubin nvl72 agentic inferencenewsletter.semianalysis.com
- 9d1aaa17 32da 4ca1 9fbdfinance.biggo.com